로컬에서 AI 영상을 만들다 보면 생성 버튼을 누르고 꽤 오래 기다립니다. 저는 RTX 3090 24GB를 쓰는데, 이번에 비교한 6.58초짜리 H3 영상도 한 번 생성하는 데 4분 넘게 걸렸습니다.
그러다 RTX 30 시리즈의 연산 제한을 푼다는 gpu-unlock을 적용해 봤습니다. 연산 벤치마크 숫자보다 궁금했던 건 단순했습니다. “지금 만들던 영상도 더 빨리 나올까? 전기는 얼마나 쓸까?”
기존 영상의 입력과 모델을 그대로 두고 적용 전후를 비교했습니다. 같은 머신의 RTX 3060 12GB에는 FLUX.2 Klein 이미지 생성을 맡겼습니다. 두 카드 모두 생성 시간과 결과물당 GPU 보드의 사용 에너지가 줄었습니다.
결과부터 보면 이렇습니다
각 GPU에서 적용 전 4회, 적용 후 4회를 실행했습니다. 아래 표에는 첫 실행을 제외한 반복 3회의 중앙값을 담았습니다.
| GPU·작업 | 측정 항목 | 적용 전 | 적용 후 | 변화 |
|---|---|---|---|---|
| RTX 3090 · H3 영상 | 서버 실행 시간 | 278.691초 | 211.109초 | 24.25% 감소 |
| RTX 3090 · H3 영상 | 평균 보드 전력 | 309.060W | 311.922W | 0.93% 증가 |
| RTX 3090 · H3 영상 | 실행당 보드 에너지 | 24.0244Wh | 18.2470Wh | 24.05% 감소 |
| RTX 3060 · Klein 이미지 | CLI 전체 시간 | 18.092초 | 11.013초 | 39.13% 감소 |
| RTX 3060 · Klein 이미지 | 생성기 기록 추론 시간 | 13.22초 | 7.25초 | 45.16% 감소 |
| RTX 3060 · Klein 이미지 | CLI 구간 평균 보드 전력 | 58.362W | 62.541W | 7.16% 증가 |
| RTX 3060 · Klein 이미지 | CLI 호출당 보드 에너지 | 0.29357Wh | 0.19069Wh | 35.04% 감소 |
시간·전력·에너지의 중앙값은 따로 계산했습니다. 표의 중앙값들을 묶어도 특정 실행 한 번의 수치와 모두 일치하지는 않습니다.
두 작업 모두 실행 중 평균 전력은 조금 높아졌습니다. 대신 작업이 더 빨리 끝나 결과물 하나를 만드는 데 쓴 GPU 에너지가 줄었습니다. GPU 보드에서 측정한 값이므로, PC 전체의 콘센트 전력이나 전기요금 절감률은 별도로 측정해야 합니다.
3090과 3060은 서로 다른 모델과 실행기를 썼습니다. 각 카드에서 적용 전후가 얼마나 달라졌는지 비교한 표이며, 두 카드의 성능 순위를 매기지는 않습니다.
gpu-unlock이 푸는 건 무엇인가요?
프로젝트 README는 GA102·GA103·GA104·GA106 계열의 일부 FP16·BF16 연산 명령 발행률 제한을 해제한다고 설명합니다. 제가 쓴 3090은 GA102이고 3060은 GA106 계열입니다.
동작 시점이 특이합니다. Linux 부팅 초기에 커널 모듈이 먼저 GPU의 속도 선택 레지스터를 바꾸고 리셋하면, 수정하지 않은 NVIDIA 드라이버가 카드를 초기화합니다. NVIDIA 드라이버를 따로 패치하는 수고를 줄이는 구조입니다.
여기에는 GPU 부팅 펌웨어의 취약점을 이용하는 V67/PLM 기법을 씁니다. 예전에 다뤘던 CMP 170HX 언락과 이어지는 기술이지만, 이번 GeForce 시험의 대상은 연산 처리량입니다. VRAM은 그대로 24GB와 12GB입니다.
README에서 설명하는 명령 발행률과 실제 작업의 단축률은 구분해야 합니다. 영상 생성에는 모델 로딩과 메모리 이동, 여러 정밀도의 연산과 인코딩이 섞여 있으므로, 저는 작업 전체에 걸리는 시간이 얼마나 달라지는지 측정했습니다.
원래 쓰던 입력으로 조건을 맞췄습니다
효과가 큰 장면을 새로 찾는 대신, 기존에 시험하던 H3 영상을 다시 생성했습니다. 회색 거리에서 흰 마네킹이 적갈색 차량 사이로 걸어오는 장면입니다.
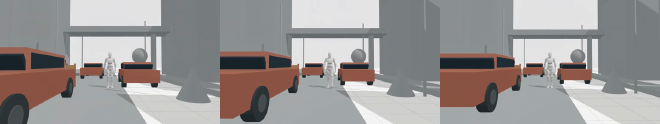
적용 후 영상의 0·79·157프레임입니다. 시작·끝 이미지와 프롬프트를 고정했고, 적용 전후 네 쌍 모두 전체 디코드 영상과 오디오의 해시가 각각 일치했습니다.
비교에 사용한 주요 조건입니다.
| 조건 | RTX 3090 영상 생성 | RTX 3060 이미지 생성 |
|---|---|---|
| GPU | RTX 3090 24GB | RTX 3060 12GB |
| 전력 제한 | 370W 고정 | 170W 고정 |
| 모델 | MiniMax H3 FL2VA INT8 | FLUX.2 Klein 4B BF16 |
| 생성 설정 | PDD 8스텝, 1024×576, 24fps, 158프레임 | 4스텝, 512×896, guidance 1.0, CPU offload |
| 시드 | 260909705 | 260909705 |
| 실행 방식 | ComfyUI 새 서버에서 첫 생성 후 3회 반복 | 매번 새 CLI 프로세스로 총 4회 호출 |
| 시간·에너지 구간 | 서버의 execution_start부터 execution_success까지 | Python 시작부터 모델 로딩·추론·이미지 저장까지 CLI 전체 |
공통 환경은 Linux 6.12.107+deb13-amd64, NVIDIA Open 드라이버 615.71.09입니다. 전후 비교를 위해 부팅할 때도 같은 커널을 선택했고, NVIDIA 드라이버·모델·생성기 패키지는 업그레이드하지 않았습니다. 클럭·전압·팬 설정과 전력 제한도 그대로 뒀습니다.
각 작업을 실행하는 동안 다른 GPU는 유휴 상태로 두어 무거운 생성 작업이 겹치지 않게 했습니다. 입력과 모델 파일의 해시도 기록했습니다.
H3는 --cache-none으로 같은 시드의 결과가 노드 캐시에서 재사용되지 않도록 했습니다. OS 페이지 캐시는 강제로 비우지 않았으므로, 여기서 첫 실행은 새 서버나 새 CLI의 첫 호출을 뜻합니다.
3090에서는 영상 한 번에 약 1분이 줄었습니다
H3의 네 실행 결과입니다. 모델 로딩·인코딩을 포함한 서버 실행 시간으로, 클라이언트의 폴링이나 파일 다운로드 시간은 제외했습니다.
| 실행 | 적용 전 | 적용 후 |
|---|---|---|
| 새 서버의 첫 생성 | 282.632초 | 206.116초 |
| 반복 1 | 280.732초 | 211.965초 |
| 반복 2 | 278.420초 | 211.109초 |
| 반복 3 | 278.691초 | 210.415초 |
반복 실행에서는 4분 39초 정도 걸리던 작업이 3분 31초 정도로 줄었습니다. 같은 컷을 여러 번 생성할 때는 꽤 반가운 차이입니다.
사용한 파일은 minimax_h3_fl2va_int8_convrot.safetensors이고, 텍스트 인코더도 기존 INT8 구성을 유지했습니다. 영상 VAE는 FP16, 오디오 VAE는 FP32입니다.
이 결과를 INT8 행렬 연산 자체의 향상률로 해석하기는 어렵습니다. 이번에는 워크플로 전체 시간을 비교했으며, 어느 연산 단계에서 시간이 얼마나 줄었는지는 따로 측정하지 않았습니다.
3060은 Klein 이미지로 비교했습니다
3060에는 H3 대신 FLUX.2 Klein 4B를 BF16과 CPU offload 설정으로 실행했습니다. 프롬프트는 회색 배경과 나무 책상 위에 빨간 도자기 머그 하나를 생성하는 내용입니다.
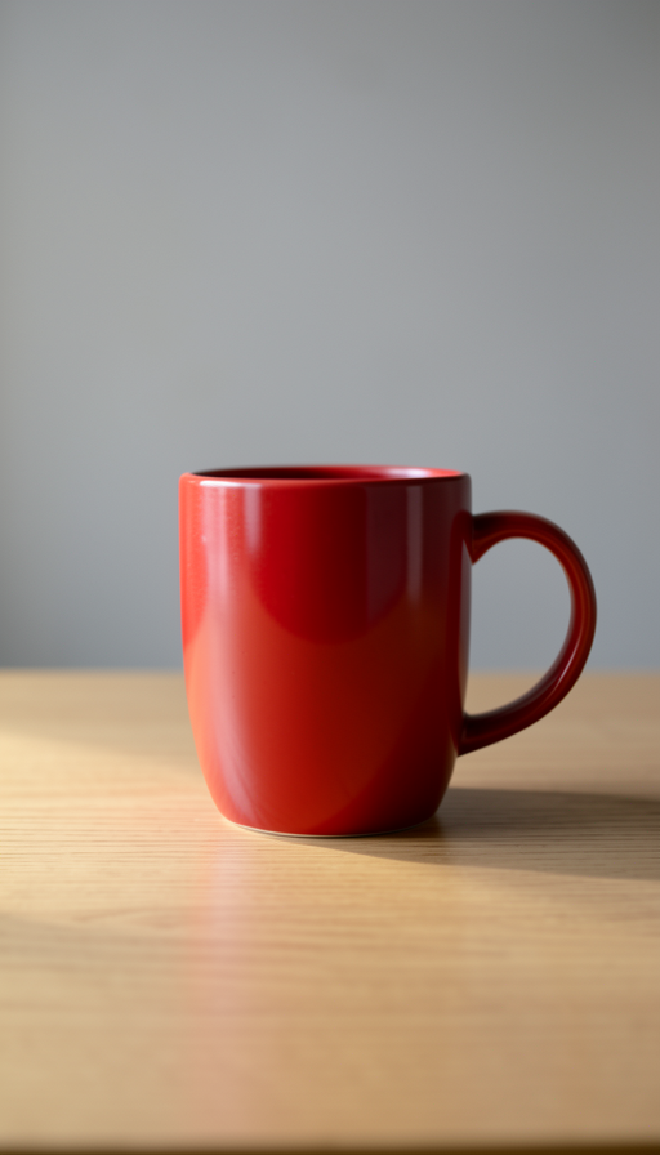
적용 후 첫 호출의 원본 PNG입니다. 적용 전후 네 쌍 모두 이미지 크기·RGB 모드·디코드한 픽셀의 SHA-256이 일치했습니다.
이쪽은 호출마다 새 Python 프로세스에서 모델을 다시 읽습니다. H3처럼 같은 서버를 계속 쓰는 조건과 달라서, CLI 전체 시간과 생성기가 별도로 기록한 추론 시간을 나눠 적었습니다.
| 호출 | 적용 전 CLI 전체 | 적용 후 CLI 전체 | 적용 전 추론 | 적용 후 추론 |
|---|---|---|---|---|
| 첫 호출 | 22.906초 | 14.444초 | 16.24초 | 8.20초 |
| 반복 1 | 32.204초 | 11.013초 | 25.86초 | 7.26초 |
| 반복 2 | 18.092초 | 11.017초 | 13.22초 | 7.24초 |
| 반복 3 | 17.206초 | 10.966초 | 12.50초 | 7.25초 |
적용 전 반복 1이 유독 느렸습니다. 원인은 확인하지 못했으며, 이 실행도 결과에 그대로 포함했습니다. 적용 전 반복 호출은 약 17~32초로 편차가 컸고, 적용 후에는 약 11초에 모였습니다.
CPU offload와 모델 로딩이 포함된 실행 경로입니다. 적용 전후 각각 한 번의 부팅 세션에서 반복했으므로, 독립적인 재부팅 실험을 여러 번 한 통계나 순수 BF16 연산 성능과는 구분해 기록했습니다.
전력은 W와 Wh를 나눠 봤습니다
nvidia-smi에 보이는 W만으로는 결과물 하나를 만드는 데 전기를 얼마나 썼는지 알기 어렵습니다. 조금 더 높은 전력으로 일하더라도 빨리 끝나면 전체 에너지는 덜 쓸 수 있습니다.
이번에는 NVML의 누적 에너지 카운터 기능으로 GPU 보드의 사용 에너지를 구했습니다. 약 200ms 간격으로 누적 에너지·전력·온도·클럭을 기록한 뒤 작업 시작과 끝의 누적 에너지 차이를 계산했습니다. 경계가 표본 사이에 걸리면 그 두 경계만 선형 보간했습니다.
- 사용 에너지 Wh = 누적 에너지 차이 mJ ÷ 3,600,000
- 평균 전력 W = 사용 에너지 J ÷ 실행 시간 초
H3의 에너지는 서버 실행 구간에서, Klein의 에너지는 모델 로딩을 포함한 CLI 전체 구간에서 측정했습니다. Klein의 짧은 추론 시간에 CLI 전체 에너지를 대응시키면 측정 구간이 어긋납니다.
NVIDIA 문서에 따르면 이번 GeForce Ampere에서 전력 API가 주는 값은 1초 평균입니다. 200ms마다 읽더라도 순간 피크를 측정할 수는 없습니다. 에너지는 이 전력 표본을 더해서 구하지 않고 별도의 누적 카운터로 계산했습니다.
유휴 전력은 빼지 않았습니다. CPU·RAM·전원공급장치 손실도 이 GPU 보드 수치에 포함하지 않았습니다. 이번에 확인한 건 두 작업의 결과물당 GPU 에너지 감소입니다.
결과물이 같은지도 확인했습니다
같은 시드라도 출력이 같다고 가정하지 않고, 생성 결과를 따로 비교했습니다.
H3는 적용 전후 네 쌍 모두 전체 영상을 디코드한 SHA-256과 오디오를 디코드한 SHA-256이 각각 같았습니다. MP4 파일 자체의 해시는 달랐습니다. 컨테이너에는 메타데이터도 들어가므로 파일 해시와 영상·오디오 내용은 분리해서 봤습니다.
Klein도 네 쌍 모두 PNG 크기·모드·디코드한 픽셀 해시가 같았습니다. 이번 입력에서는 결과 내용은 같고 생성 시간은 줄었습니다.
영상은 처음·중간·마지막 프레임을 열어 확인했습니다. 전체 청취와 작품 완성도 평가는 이번 성능 비교에서 진행하지 않았습니다.
Debian 설치는 부팅 설정까지 이어졌습니다
시험에 사용한 gpu-unlock은 1.0.0, 커밋은 af28cbbfd3d922a659227ecfb7369adfd924cf03입니다. Debian용 설치 대상인 make install-deb로 빌드하고 설치했습니다.
같은 소스 버전을 선택하는 명령입니다.
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
git checkout af28cbbfd3d922a659227ecfb7369adfd924cf03
make install-deb
설치 과정에서 입력 파일의 체크섬 검증과 패키지 테스트 5개가 통과했고, gpu-unlock-dkms와 gpu-unlock-firmware 패키지가 추가됐습니다. 기존에 설치된 세 커널의 DKMS 빌드와 initramfs 갱신도 끝났습니다.
패키지를 설치한 뒤에는 부팅 대상을 지정해야 합니다. 모듈이 initramfs에 들어 있어도 커널 명령행에 대상을 지정해야 잠금 해제를 시도합니다. 저는 모든 카드를 뜻하는 all 대신 두 GPU의 PCI 주소를 직접 지정했습니다.
gpu_unlock.targets=0000:09:00.0,0000:0a:00.0 gpu_unlock.resume=1
이 주소는 제 머신 기준입니다. 다른 머신에서는 lspci -D로 확인한 주소를 사용합니다. 저는 기존 부팅 옵션을 유지하면서 /etc/default/grub.d/90-gpu-unlock.cfg에 옵션을 추가하고 GRUB 설정을 갱신했습니다.
현재 커널의 initramfs를 풀어 모듈과 필요한 펌웨어가 들어 있는지 확인했습니다. 잠금 해제 스크립트가 udev보다 먼저 실행되는지도 살폈습니다. 부팅 후 이미 NVIDIA 드라이버가 잡은 카드에 모듈을 올리는 방식으로는 적용되지 않습니다.
비교용으로 실제 재부팅한 뒤에는 같은 6.12.107 커널에서 두 카드 모두 gpu_unlock: unlocked 로그가 남았습니다. 드라이버 버전과 전력 제한도 기존 값으로 돌아왔고, 그 상태에서 적용 후 생성을 진행했습니다.
한 번 멈춘 건 검증 코드였습니다
재부팅 뒤 첫 자동 실행은 H3 요청을 제출하기 전 환경 검사에서 멈췄습니다. 부팅 전후 Linux의 총 사용 가능 RAM이 8,192바이트 달라졌는데, 계측 코드가 이 관측값을 고정된 소프트웨어 구성처럼 비교한 탓입니다.
버전과 실행 옵션은 같았습니다. 부팅마다 달라질 수 있는 RAM 관측값을 소프트웨어 구성 대조에서 분리하되, 원본 값과 실패 로그는 남겼습니다. 그사이 완료된 3060 결과는 다시 생성하지 않고 보존했으며, H3만 재개해 네 번을 끝냈습니다.
상시 적용과 복구 항목은 따로 뒀습니다
시험 후에는 두 카드 모두 일반 부팅에서 잠금 해제를 적용하도록 유지했습니다. 절전 복귀 시 재적용 옵션도 켜 뒀습니다.
복구용으로 GPU unlock DISABLED - recovery 항목을 따로 준비했습니다. 이 항목은 gpu_unlock.targets=를 비우고 gpu_unlock.resume=0으로 부팅합니다. 부팅이 멈추면 전원을 완전히 끈 뒤 잠금 해제 없는 항목을 고를 수 있게 했습니다.
일반 Debian 항목에도 이미 잠금 해제 옵션을 넣어 뒀습니다. 따라서 기본 항목으로 돌아가는 것만으로는 비적용 복구가 되지 않습니다. GRUB 설정·환경·initramfs 원본도 설치 전에 백업했습니다.
설정만 끝낸 항목과 실제 동작을 확인한 항목은 아래처럼 나눴습니다.
| 항목 | 이번에 확인한 상태 |
|---|---|
| Linux 6.12.107 실제 재부팅 | 두 GPU 잠금 해제 로그와 생성 완료 확인 |
| 다음 일반 부팅 설정 | 기존 기본 커널 선택 유지, 두 GPU 적용 옵션 포함 |
| Linux 6.12.113 | DKMS·부팅 항목 생성 확인, 실제 하드웨어 부팅 미시험 |
| 절전 복귀 | 재적용 옵션 설정, 실제 suspend/resume 미시험 |
| 측정 종료 후 커널 로그 | NVIDIA Xid·GPU fallen-off·잠금 해제 실패 패턴 미발견 |
외부 커널 모듈과 서명 관련 taint 경고는 원본 로그에 남아 있습니다. gpu-unlock은 GPU의 부팅 동작에 개입하는 비공식 모듈이며, 제가 확인한 범위는 이번 커널·드라이버 조합에서 재부팅과 생성 작업을 마친 데까지입니다. 장기 안정성은 더 사용하면서 확인해야 합니다.
벤치마크를 자동 실행하던 일회성 서비스는 종료·비활성화했습니다. 측정 자동화는 끝내고 GPU 잠금 해제 기본값은 유지하도록 각각 처리했습니다.
정리하면
제가 원했던 건 연산 벤치마크의 큰 숫자보다 평소 작업에서 기다리는 시간을 줄이는 것이었습니다. 이번 H3 영상과 Klein 이미지에서는 그 효과를 확인했습니다. 출력 해시도 같았습니다.
모델과 정밀도, CPU offload 여부가 다르면 이득도 달라집니다. 특히 부팅 환경에 손대는 작업이라, 제 머신에서는 비적용 복구 항목을 함께 남겨 두는 쪽을 택했습니다.
일단 두 카드 모두 적용한 상태로 쓰기로 했습니다. 같은 영상을 기다리는 시간이 1분가량 줄어든 건 제 작업에서는 꽤 만족스럽습니다.
참고 자료
- 자체 실험 기록: 2026년 10월 26일 측정. RTX 3090 H3와 RTX 3060 Klein 각각 적용 전후 4회. 입력·모델 해시, 실행별 생성 로그, 전력·누적 에너지 표본, 출력 비교 결과 보존.
- gpu-unlock 시험 버전의 README
- How Ampere was unlocked: 동작 원리 설명
- NVIDIA NVML Device Queries: 전력·누적 에너지 API
- 이전 글: CMP 170HX 64GB 언락을 뒤늦게 찾아본 이야기
댓글