며칠 전 Jev를 정리한 글을 썼는데, 이번에는 Laya 소개 글이 눈에 들어왔습니다. state를 넣고 Choice·Score·Noul로 질문하면 확률을 돌려준다니, 처음에는 “이거 Jev를 오픈소스로 풀어놓은 건가?” 싶었어요.
그런데 순서는 반대였어요. Laya 개발자 Nandakishor M은 Jev가 공개되기 한참 전인 2025년 3월에 세일즈 대화의 전환 가능성을 확률로 예측하는 연구를 발표했습니다. 지금의 Laya는 그때의 특정 용도 모델을 여러 업무에 쓸 수 있는 판단형 모델로 확장한 결과입니다. Jev보다 먼저 시작된 작업이 Jev 출시 뒤에 새삼 주목받는 상황인 거죠.
쓰는 방식은 확실히 닮았습니다. 다만 TypeSafe가 Jev의 가중치를 공개한 것이 아니라 Convai Innovations가 별도로 만든 모델입니다. Laya의 코드와 모델 가중치는 공개돼 있고 Apache 2.0 라이선스를 표시합니다. Jev는 TypeSafe가 호스팅하는 API로 이용합니다. 여기서부터는 꽤 다르죠.
지금 공개 자료를 기준으로 볼 핵심은 세 가지입니다. Laya는 직접 운영할 수 있는 판단형 모델입니다. 용도에 따라 체크포인트가 셋이고, Jev보다 빠르고 정확하다는 홍보 수치는 같은 조건의 직접 대결에서 나오지 않았습니다. 초기 소개 글 이후 모델 카드도 여러 번 바뀌어서, 아래는 9월 23일에 확인한 카드와 벤치마크 문서를 기준으로 정리했습니다.
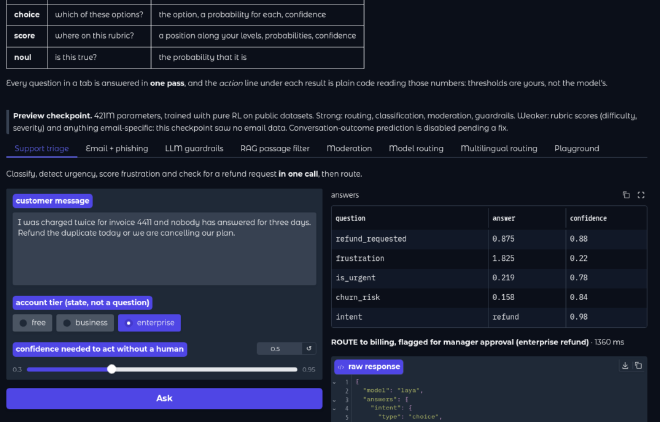
2026년 9월 23일 공식 Hugging Face 데모에서 제공된 예시 문의로 Ask를 실행한 화면. 응답 표와 처리 경로는 데모 출력이며, 이 한 건으로 정확도나 지연시간을 평가할 수는 없습니다. 출처: https://huggingface.co/spaces/convaiinnovations/laya-demo
Jev와 어떤 부분이 같을까요?
둘 다 긴 답변을 쓰기보다 코드가 다음에 할 일을 고르는 데 초점을 둡니다. 입력 자료를 state로 보내고, 그 자료에 대해 답할 질문을 정의합니다. 예를 들어 환불 문의 한 건에서 담당 부서를 고르고(choice), 불만의 정도를 단계로 평가하고(score), 환불 요청 여부를 확률로 받을 수 있습니다(noul).
| 질문 유형 | 반환하는 값 | 문의 처리 예시 |
|---|---|---|
choice | 선택한 항목, 항목별 확률, confidence | 결제·기술지원·영업 중 어느 팀으로 보낼까? |
score | 순서가 있는 단계의 기대 점수, 분포, confidence | 불만 강도는 0~3 중 어느 정도일까? |
noul | 참일 확률 P(true) | 환불을 명시적으로 요청했나? |
Laya 모델 카드에 따르면 여러 질문을 한 번의 forward pass에서 평가합니다. 각 선택지에 마커를 놓고 점수를 매긴 뒤 질문 안의 선택지에 확률을 배분하는 방식입니다. 문장을 한 토큰씩 이어 쓰는 생성형 LLM과 다른 지점이에요.
Jev의 공식 문서에도 세 질문 유형과 공유 state가 나옵니다. API를 그대로 호환하는지는 별개입니다. Laya가 제공하는 것은 자체 Python 패키지의 predict(state, questions) 호출이고, Jev는 TypeSafe의 POST /v1/systemone API입니다. 같은 개념을 쓴다는 사실과 기존 Jev 애플리케이션을 코드 수정 없이 교체할 수 있다는 주장은 구분해야 합니다.
오픈소스로 공개된 범위는 어디까지인가요?
GitHub 저장소에는 Python SDK, 라우터, 평가 스크립트, 일부 실험 결과와 파인튜닝 노트북이 있습니다. Hugging Face에는 세 체크포인트의 safetensors 가중치가 올라와 있습니다. 저장소와 모델 카드에는 Apache 2.0 라이선스가 명시돼 있어요. 자체 서버에서 실행할 수 있다는 것이 Jev API와 가장 큰 운영상 차이입니다.
| 체크포인트 | 기반 모델·크기 | 기본 입력 길이 | 현재 문서가 권하는 용도 |
|---|---|---|---|
laya | ModernBERT-large, 4억 2100만 파라미터 | 질문당 512토큰 | 영어 입력 |
laya-multilingual | mmBERT-base, 3억 2200만 파라미터 | 질문당 1024토큰 | 한국어 등 비영어 입력 |
laya-typed-decisions | ModernBERT-large, 4억 2100만 파라미터 | 질문당 1024토큰 | 특정 네 업무 흐름으로 파인튜닝한 전문 모델 |
첫 소개 글은 영어 기반 4억 2100만 파라미터 모델 하나를 다뤘습니다. 지금 루트 모델 카드는 다국어 모델과 업무별 전문 모델까지 포함하는 제품군 안내로 바뀌었어요. 맨 위의 “100개 이상 언어” 문구는 이 제품군에 대한 설명입니다. 루트의 영어 체크포인트 하나가 한국어를 잘 처리한다는 의미로 읽으면 실제 평가와 어긋납니다.
PyPI 패키지의 설치 명령은 pip install laya입니다. 현재 모델 카드의 직접 로딩 예시를 한국어 문의에 맞춰 줄이면 이렇게 쓸 수 있습니다. 실제 반환 확률은 입력과 모델 상태에 따라 달라집니다.
import laya

agent = laya.load("convaiinnovations/laya-multilingual")
result = agent.predict(
    {"body": "결제가 두 번 됐습니다. 중복 결제 건을 환불해 주세요."},
    {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "payments and refunds",
                "technical": "bugs and outages",
                "other": "other requests",
            },
        },
        "refund_requested": {
            "type": "noul",
            "instructions": "Does the sender explicitly request a refund?",
        },
    },
)
print(result["answers"]["department"]["choice"])
print(result["answers"]["refund_requested"]["noul"])
한 서비스에서 영어와 한국어가 섞이면 내장 Router가 입력의 언어·문자 체계를 살펴 체크포인트를 고릅니다. 다만 기본 설정은 모델 하나만 메모리에 유지해 언어가 바뀔 때 다시 로드할 수 있습니다. 제작자가 공개한 측정에서는 이런 전환에 수 초가 걸렸고, 서버에서는 필요한 모델을 미리 적재하는 Router(preload=True) 구성을 권장합니다. 모델을 직접 운영하면 API 토큰 요금 대신 모델 파일, 메모리, 연산 자원과 운영비를 감당합니다.
“Jev보다 정확하다”는 숫자는 무엇을 잰 걸까요?
Laya의 최신 벤치마크 문서는 전문 체크포인트 laya-typed-decisions가 정확도 0.766을 기록했다고 적습니다. Typed Decisions 데이터셋의 네 업무 흐름에서 학습용 1200개 사례를 써서 파인튜닝하고, 별도 시험용 400개 사례에 담긴 결정 2000개를 평가한 결과입니다. 문의 처리, 인보이스 검토, 보안 사고, 에이전트 실행 기록을 다룹니다.
같은 자료에서 파인튜닝 전 기본 laya의 점수는 0.362, 다국어 모델은 0.342입니다. 시험용 데이터의 다수 라벨만 찍는 기준선 0.47에도 못 미칩니다. 0.766을 Laya 기본 모델의 범용 제로샷 성능으로 소개하면 정반대 이야기가 돼요.
데이터의 정답도 살펴봤습니다. 사례의 조건과 본문을 합성하고, 약 40억 파라미터급 교사 모델의 답을 사례별로 세 번 샘플링해 평균 확률을 정답 분포로 만든 벤치마크입니다. 따라서 0.766은 실제 고객 문의에서 확인한 정답률이 아니라, 그 시험의 교사 모델 라벨과 얼마나 일치하는지를 나타냅니다.
Laya 카드가 인용한 Jev 1.13.0의 0.727은 이 데이터셋의 외부 게시 결과입니다. Jev는 해당 네 업무의 학습 자료로 따로 파인튜닝하지 않은 범용 모델이고, Laya는 바로 그 자료의 학습 분할로 특화했습니다. Laya 개발팀도 Jev API에 접근해 같은 실행 조건으로 재측정한 값이 아니라고 밝힙니다. 두 숫자를 붙여 “Laya가 Jev를 이겼다”라고 결론 내리기는 어렵습니다.
확률 자체도 다른 방향으로 움직입니다. 전문 모델 카드에서 Laya의 가장 높은 확률을 고른 정확도는 0.766이지만, 정답 확률분포 전체와 얼마나 닮았는지를 보는 soft accuracy는 0.471로 게시된 Jev의 0.580보다 낮습니다. 이 역시 측정 출처와 모델 조건을 단서로 둔 비교예요. 자동화에서 필요한 것은 정답 항목뿐 아니라 얼마나 틀릴 수 있는지에 대한 확률이라는 점이 드러납니다.
속도는 빠른데, 어떤 시간을 재고 있나요?
Laya 팀의 Tesla T4 측정에서 한 질문을 처리한 시간은 영어 모델 39.5ms, 다국어 모델 32.8ms입니다. 질문 10개를 묶으면 각각 158.6ms, 72.3ms였어요. 한 번의 로컬 GPU 추론 시간입니다.
외부 Jev 벤치마크는 호스팅된 API의 요청 지연 중앙값을 264~276ms로 보고합니다. 네트워크 왕복, 서버 대기, 실행 지역을 포함한 시간과 로컬 GPU 추론만 잰 시간을 나눠 배속을 계산하면 모델 속도 차이와 운영 환경 차이가 한데 섞입니다. 한국에서 Jev API를 호출하거나 Laya를 자체 서버에 얹으면 또 다른 숫자가 나옵니다.
제가 Laya 공식 데모의 제공된 예시 문의에 Ask를 눌렀을 때는 화면에 환불 요청 확률과 담당 경로가 나왔습니다. 위 캡처가 그 결과입니다. 공개 데모는 ZeroGPU에서 도는 별도 서비스이고, 화면의 한 번 나온 응답 시간은 T4 벤치마크의 재현값으로 취급하지 않았습니다.
비용도 마찬가지입니다. Jev 공식 가격은 입력 100만 토큰당 0.042달러, 출력 토큰은 무료입니다. Laya에는 그 API 사용료가 없지만 자체 호스팅 GPU·CPU와 관리비가 듭니다. 어떤 쪽이 저렴한지는 처리량과 운영 형태에 따라 달라져요.
한국어와 확률 보정은 어느 정도일까요?
다국어 모델 카드는 100개 이상 언어를 다룬다고 설명하지만, 공개된 MASSIVE 실험은 51개 언어, 20개 선택지의 의도 분류를 측정합니다. 개발팀은 그중 45개 언어가 무작위 선택 정확도의 세 배를 넘었다고 보고했어요. 한국어도 다국어 체크포인트가 영어 전용 체크포인트보다 높았지만, 한 분류 데이터셋의 결과를 한국어 문의 전체의 성능으로 옮길 수는 없습니다.
Laya가 RLCD라는 학습법으로 확률을 다룬다는 설명도 눈에 띕니다. 하지만 모델 카드의 한계 항목은 출고 상태의 과신을 인정합니다. 영어 모델의 평균 ECE가 온도 재적합 전 0.466에서 재적합 후 0.081로 내려갔다는 수치가 있습니다. 다국어 모델은 출고 상태에서 별도로 맞춘 온도가 없다고 해요. 이는 Laya 모델군 전체가 처음부터 “정답일 확률”을 보장한다는 말과는 거리가 있습니다. 실제 업무 데이터의 보정용 분할을 두고 다시 측정해야 하는 값입니다.
입력 길이도 Jev와 차이가 납니다. Laya의 기본 영어 모델은 질문당 512토큰, 다국어와 전문 모델은 1024토큰을 기본 예산으로 씁니다. 선택지 설명이 그 안에서 공간을 차지해 선택지가 많으면 본문에 남는 공간도 줄어요. 개발팀의 77개 선택지 시험에서 낮은 정확도가 나온 이유로 이 예산을 직접 지목합니다. Jev 문서는 요청 전체 64k토큰, state와 가장 긴 질문을 합쳐 32k토큰을 허용합니다. 긴 문서나 수십 개 선택지를 그대로 넣는 작업에서는 두 제품의 차이가 큽니다.
“텍스트를 생성하지 않으니 환각이 없다”는 Laya 소개 문구는 출력 형식의 장점을 말합니다. 존재하지 않는 선택지를 문장으로 지어내는 문제는 줄지만, 잘못된 항목을 높은 확률로 고르는 오판은 여전히 가능합니다. 영어 체크포인트가 일부 비영어 입력에서 높은 확신으로 틀린다는 개발팀 자체 결과가 그 예입니다.
어느 쪽을 어디에 쓰면 좋을까요?
Jev는 긴 state를 넣어 별도 모델 운영 없이 API로 시험해 볼 때 편합니다. 모델 버전과 요금은 TypeSafe 문서에 명시돼 있고, 한국어는 입력할 수 있지만 영어가 주 학습 언어입니다. Laya는 데이터가 외부 API로 나가기 어려운 환경, 반복적인 소규모 분류를 자체 서버에서 처리하는 환경, 자체 데이터로 모델을 특화할 수 있는 팀에 선택지가 하나 더 생긴 셈이에요.
반대로 학습 데이터 없이 아무 업무 질문이나 넣는다면 Laya 기본 모델의 낮은 제로샷 수치를 먼저 봐야 합니다. 한국어의 실무 결과, 확률 보정, 긴 입력, 선택지가 많은 분류도 용도별로 다르게 나옵니다. 모델 카드의 좋은 숫자 하나로 Jev를 대체할 수 있다고 말하기에는 간격이 있습니다.
먼저 공개한 개발자는 어떤 기분일까요?
Jev 출시 뒤에야 이런 판단형 모델이 크게 주목받는 모습을 보니, 저는 Laya를 만든 개발자의 기분도 궁금해졌습니다. 개발자 Nandakishor M은 2025년 3월 논문에서 세일즈 대화의 전환 확률을 예측하는 앞선 작업을 공개했습니다. 당시 모델은 세일즈라는 특정 문제를 풀었고, 지금의 Laya는 질문과 선택지를 그때그때 정의하는 범용 모델로 확장됐습니다.
그는 Jev 출시 후 쓴 글에서 이 분야가 화제가 된 일을 반갑게 여기면서도 깊이 답답했다고 말합니다. 오래 공개해 온 작업보다 상용 모델의 출시가 훨씬 큰 관심을 받은 셈이니까요. 개발자 입장에서는 “내가 붙들고 있던 문제가 정말 중요했구나” 싶어 기쁘다가도, 왜 그동안은 별로 보이지 않았을까 하는 아쉬움이 남을 것 같습니다.
저는 그 두 감정이 함께 드는 게 이해됩니다. Jev 덕에 판단형 모델을 써보려는 사람이 늘면 공개 모델인 Laya에도 기회가 생깁니다. 동시에 좋은 아이디어를 먼저 공개하는 일과 사람들이 그 아이디어를 알아보는 일 사이에는 큰 간격이 있다는 것도 보이네요. 이번 이야기는 어느 쪽이 먼저였는지보다, 작은 팀의 작업이 언제 주목받는지를 생각하게 했습니다.
정리하면
제가 처음 떠올린 “오픈소스 Jev”라는 비유는 입력·질문·확률을 주고받는 사용 방식에 잘 맞습니다. 구현 주체는 다르고, Laya는 코드와 가중치를 공개한 별도 모델입니다. 초기 소개 글에 실린 정확도 83.8%, 제로샷 65.1%, Jev 대비 10.4배 같은 숫자는 현재 공개된 세 체크포인트의 평가 문서와 같은 조건의 최신 결과로 이어 붙일 근거가 없습니다.
제 관심은 홍보용 승부보다 실무에서 조정할 수 있는 범위에 있습니다. 짧은 분류 작업을 직접 호스팅하고, 내 데이터로 특화하고, 확률이 틀어질 때 보정할 수 있다는 점은 분명 매력적입니다. 어느 모델이 더 낫다는 답은 같은 한국어 입력과 같은 판단 기준을 놓고 재봐야 나올 것 같습니다.
댓글