미모 새 모델 소식을 보던 날, 그록도 업데이트됐다는 소식이 들어왔습니다. 이번 모델은 Grok 4.7입니다. SpaceXAI가 9월 21일 공식 발표했고, 장시간 코딩과 문서 작업을 주요 개선점으로 내세웠습니다.
발표문에서 먼저 눈에 들어온 건 가격이었습니다. Grok 4.6과 같은 토큰 단가에 성능을 높였다고 합니다. 다만 외부 평가에서는 출력 토큰 사용량도 꽤 늘었습니다. 단가가 같아도 작업 하나를 끝내는 비용은 더 들 수 있겠습니다.
이번 글은 공식 발표와 Artificial Analysis의 공개 평가를 정리한 글입니다.
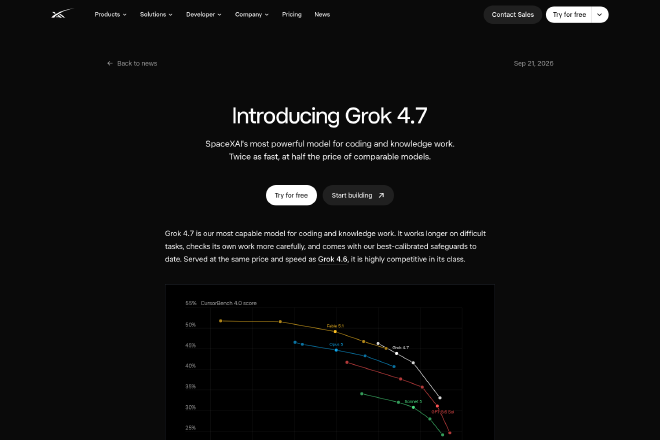
2026년 9월 22일 확인한 공식 발표 화면입니다. Grok 4.6과 같은 가격과 제공 속도를 강조합니다. 출처: https://x.ai/news/grok-4-7
이번 그록은 오래 걸리는 작업에 힘을 줬습니다
공식 발표에 따르면 Grok 4.7은 4.6보다 큰 기반 모델을 사용합니다. 여러 시간이 걸리는 문제의 비중을 높이고, 더 어려운 작업을 섞어 강화학습을 오래 진행했다고 합니다. 정확한 파라미터 수는 발표문에 없습니다.
회사가 강조한 변화는 자기 작업을 다시 확인하는 능력과 긴 문맥 관리입니다. 코드를 한 번 생성하고 끝내는 작업보다, 저장소를 읽고 수정하고 검증하는 과정을 오래 이어가는 데 초점을 맞췄습니다. Grok Bot 실행 환경을 이해하도록 학습한 점도 함께 소개했습니다.
API 모델 문서에 나온 기본 사양은 다음과 같습니다.
| 항목 | Grok 4.7 |
|---|---|
| 입력과 출력 | 텍스트·이미지 입력, 텍스트 출력 |
| 컨텍스트 창 | 50만 토큰 |
| 모델 ID | grok-4.7 |
| 추론 강도 | low, medium, high, xhigh |
| 기본 추론 강도 | high |
| 도구 호출·구조화된 출력 | 지원 |
| Batch API | 미지원 |
컨텍스트 크기는 Grok 4.6과 같습니다. 이번에는 긴 문맥을 관리하면서 작업을 이어가는 능력에 집중했습니다.
외부 평가에서도 코딩 성능이 올랐습니다
Artificial Analysis의 9월 21일 평가에서 Grok 4.7은 Intelligence Index 46점을 기록했습니다. Grok 4.6보다 2점 높습니다. 새 모델은 xhigh 추론 강도로 평가했습니다.
코딩 에이전트 결과는 변화가 더 큽니다. Grok Build와 Grok 4.7을 함께 사용해 측정한 Coding Agent Index는 56점. 이전 Grok 4.6 조합의 47점에서 9점 올랐어요. 두 코딩 평가 모두 xhigh 설정입니다.
| Artificial Analysis 코딩 평가 | Grok 4.6 + Grok Build | Grok 4.7 + Grok Build |
|---|---|---|
| Coding Agent Index | 47 | 56 |
| DeepSWE v1.1 | 65% | 73% |
| Terminal-Bench 4.0 | 18% | 33% |
| SWE-Atlas-QnA | 58% | 63% |
평가 공개 시점에 각 모델의 자체 코딩 도구를 사용한 조합 중에서는 4위였습니다. 앞에는 Claude Fable 5.1, GPT-6 Astra, Claude Opus 5가 있었습니다.
이 수치에는 Grok Build의 파일 읽기, 도구 호출, 실패 복구 방식도 영향을 줍니다. Grok 4.7을 OpenCode나 다른 하네스에 연결한 결과는 이 표에 없습니다.
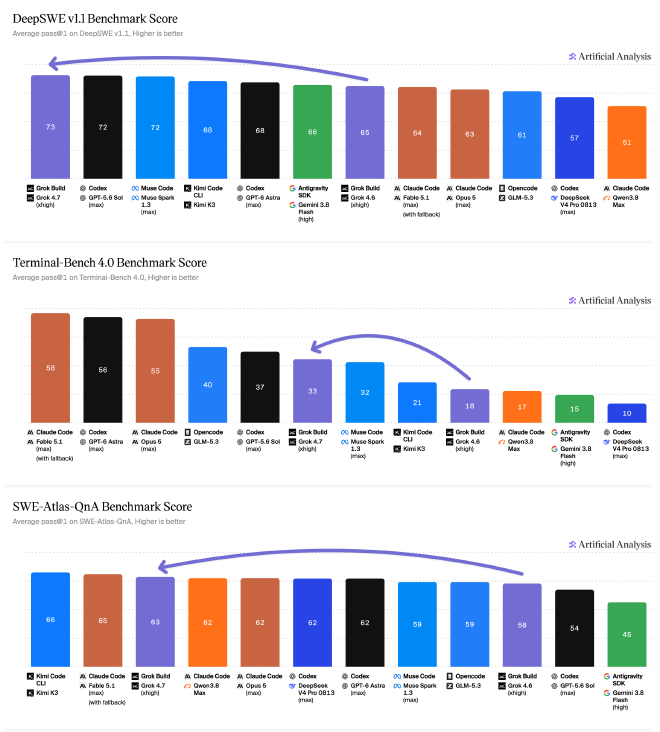
Grok 4.6과 4.7을 각각 Grok Build에서 xhigh 설정으로 평가한 결과입니다. 세부 항목의 개선 폭은 서로 다릅니다. 출처: https://artificialanalysis.ai/articles/benchmarking-grok-4-7
문서와 분석 업무도 좋아졌습니다. 같은 외부 평가에서 AA-Briefcase는 1,657 Elo, GDPval-AA는 1,695 Elo를 기록했습니다. 비교 대상인 Grok 4.6 high보다 각각 111, 90 Elo 높습니다. 이전 모델의 설정은 high, 새 모델은 xhigh였습니다.
AA-Briefcase 세부 결과를 보면 분석 품질은 1,690→1,994 Elo로 올랐지만, 표현·구성 품질은 1,519→1,499 Elo로 조금 내려갔습니다. 두 항목은 서로 다른 방향으로 움직였습니다.
공식 코딩 평가도 추론 강도에 따라 결과가 달라집니다
SpaceXAI는 CursorBench 4.0에서 가격 대비 성능을 강조합니다. 현재 공식 발표 페이지에는 점수와 작업당 평균 비용을 볼 수 있는 그래프가 있습니다.
| 공식 CursorBench 4.0 비교 | 점수 | 작업당 평균 비용 |
|---|---|---|
| Grok 4.7 High | 43.9% | 4.69달러 |
| Grok 4.7 Extra High | 46.3% | 6.01달러 |
| Claude Fable 5.1 Low | 45.1% | 5.44달러 |
| Claude Fable 5.1 Max | 51.8% | 17.28달러 |
Grok 4.7의 최고 점수는 이 표에서 Fable 5.1 Max보다 낮고, 비용도 낮습니다. Fable 5.1 Low와 비교하면 점수와 비용 차이가 모두 작아집니다. 어느 추론 강도를 고르느냐에 따라 비교가 꽤 달라집니다.
공식 개선표의 Grok 4.6 CursorBench 점수는 high 기준 40.4%, Grok 4.7은 xhigh 기준 46.3%입니다. 이 차이에는 모델 변경과 추론 설정 변경이 함께 들어 있습니다.
공식 표의 DeepSWE 71.0%는 high effort로 측정한 값입니다. Artificial Analysis의 73%는 Grok Build의 xhigh 결과입니다. 평가 도구와 추론 설정이 서로 다릅니다.
더 많이 생각하고, 더 많은 토큰을 씁니다
성능 향상과 함께 확인된 변화가 출력량입니다. Artificial Analysis는 Intelligence Index 과제 하나당 Grok 4.7 xhigh가 평균 약 8만 1천 출력 토큰을 사용했다고 밝혔습니다. Grok 4.6 xhigh의 약 3만 8천 토큰보다 두 배 이상입니다.
같은 글에서 Grok 4.6 high의 출력량은 약 3만 6천 토큰으로 제시합니다. 이전 모델도 추론 강도에 따라 출력량이 달랐습니다.
긴 프롬프트에서 답변 출력 속도는 약 188토큰/초였고, Intelligence Index 과제당 평균 소요 시간은 약 7.1분이었습니다. 전자는 토큰을 내보내는 속도, 후자는 과제를 끝내는 데 걸린 시간입니다.
저는 완성도와 함께 작업 시간과 비용도 궁금합니다. 한 번에 해결하는 문제가 늘어도 추론과 도구 호출에 더 많은 시간을 쓸 수 있기 때문입니다. 이번 평가에서는 코딩 성능과 토큰 사용량이 함께 늘었습니다.
API 가격은 캐시와 긴 문맥까지 봤습니다
공식 가격표는 입력 100만 토큰당 2달러, 출력 6달러부터 시작합니다. 여기에 캐시 읽기와 긴 프롬프트 요금이 따로 붙습니다.
아래 금액은 모두 100만 토큰당 미국 달러 기준입니다.
| 요청의 프롬프트 길이 | 일반 입력 | 캐시된 입력 | 출력 |
|---|---|---|---|
| 20만 토큰 미만 | 2달러 | 0.50달러 | 6달러 |
| 20만 토큰 이상 | 4달러 | 1달러 | 12달러 |
프롬프트가 20만 토큰 이상 길어지면 해당 요청 전체의 토큰에 높은 요율이 적용됩니다. 지원하는 컨텍스트는 50만 토큰이고, 이 범위에서도 요금은 프롬프트 길이에 따라 달라집니다.
에이전트는 대화 이력과 저장소 문맥을 반복해서 보냅니다. 비용에는 새 프롬프트와 최종 답변 외에 반복 전송한 문맥도 포함됩니다. 캐시된 입력은 단가가 낮아도 양이 많으면 누적 금액이 커질 수 있습니다.
가령 여러 요청의 합계가 일반 입력 100만, 캐시 입력 2,000만, 출력 10만 토큰이라고 해보겠습니다. 각 요청의 프롬프트가 모두 20만 토큰 미만이라면 기본 요금 계산은 2 + 10 + 0.6 = 12.60달러입니다. 도구 사용료 등은 제외한 예시이고, 이 금액에서 가장 큰 항목은 캐시 읽기입니다.
별도 fast variant도 발표했습니다. 회사 설명으로는 출력 속도가 두 배이고 가격도 두 배입니다. 일반 Grok 4.7과 가격이 다른 고속 옵션입니다.
안전장치도 함께 업데이트했습니다
SpaceXAI는 Grok 4.7에 새로운 안전장치를 적용했고, 자사 테스트에서 거부 동작과 탈옥 공격 저항성이 가장 좋았다고 설명합니다.
발표에 인용된 LatchBio 생물안전성 벤치마크 점수는 62.4%입니다. 자사 HackerBench v0.3에서는 위험한 이중용도 요청을 허용한 비율이 3.3%였고, 정상적인 보안 업무를 차단하는 비율은 낮았다고 밝혔습니다. 방어 연구용 레드팀 기능은 일부 사이버보안 파트너에게 초대 방식으로 제공합니다.
각 점수는 해당 벤치마크의 과제와 채점 방식에 따른 결과입니다. 일반 코딩 정확도나 실제 환경의 모든 공격에 대한 방어 성공률은 이 자료에 없습니다. 코딩 능력 개선과 위험한 요청을 거르는 작업을 함께 진행했다고 합니다.
어디서 쓸 수 있나요?
출시 공지 기준으로 Cursor, Grok Build, Grok API에서 사용할 수 있고, 서드파티 코딩 도구와 모델 라우터·클라우드 플랫폼으로도 제공됩니다. API에서는 grok-4.7을 지정합니다.
공식 발표 끝에는 Grok Build 무료 체험 안내가 있습니다. API에는 위의 유료 가격표가 적용됩니다. 발표문에는 무료 체험의 상세 이용 조건과 무제한 제공 안내가 없습니다.
예전에 소개한 Grok Bot은 일을 실행하는 에이전트 제품이고, 이번 Grok 4.7은 그 안팎에서 쓰는 모델입니다. 기존 글에서는 제품의 운영 방식을 다뤘고, 이번 글에서는 모델의 성능 변화를 살펴봤습니다.
정리하면
저는 Grok 4.7도 코딩 에이전트 후보로 비교해 볼 만하다고 생각합니다. 외부 평가에서 Grok Build 조합의 코딩 점수가 올랐고, 문서·분석 업무도 개선됐습니다. Grok 4.6과 토큰 단가도 같습니다.
반면 토큰 사용량은 늘었고, 일부 긴 문맥·자동화 항목은 외부 평가에서 소폭 내려갔습니다. 빠른 출력과 짧은 작업 시간도 서로 다른 지표였습니다.
자주 맡기는 작업 몇 개로 완성도와 총비용을 비교해 보고 싶습니다. 특히 오래 걸리는 코딩 작업에서는 정답을 냈는지와 함께, 그 답을 얻기까지 얼마나 오래 돌았는지가 궁금합니다.
댓글