트롤링의 GPT-6 Sol·Luna 소식을 보고 먼저 궁금했던 건 반값이 된 모델에 실제 코딩을 맡겨도 되는지였습니다. 발표문만 보면 Sol과 Luna 모두 성능이 좋아지고 가격도 내려간 듯합니다. 하지만 Artificial Analysis의 독립 평가에는 성능이 내려간 항목도 있었습니다.
출시 직후 개발자들이 올린 작업 사례와 불만도 함께 찾아봤습니다. 점수와 후기가 말해주는 범위를 나눠 정리했습니다.
OpenAI가 2026년 9월 22일 공개한 두 모델의 공식 이미지입니다. 출처: https://openai.com/index/introducing-gpt-6-sol-and-luna/
먼저 가격표부터 보면
OpenAI 발표 기준으로 두 모델은 9월 22일 공개됐습니다. Astra 아래에 Sol과 Luna를 추가하면서 GPT-5.6의 프로모션 가격과 비교해 입력 단가를 절반으로 내렸어요. 아래는 OpenAI API 표준 요금표의 짧은 문맥 기준, 토큰 100만 개당 미국 달러입니다.
| 모델 | 입력 | 캐시된 입력 | 출력 |
|---|---|---|---|
| GPT-5.6 Sol | $4 | $0.40 | $20 |
| GPT-6 Sol | $2 | $0.20 | $10 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Luna는 출력 가격이 $1.20에서 $0.50으로 내려가 약 58% 저렴해졌습니다. 발표문의 ‘50% 인하’보다 출력 쪽 인하 폭이 더 큽니다. 비교 대상인 GPT-5.6 Sol의 $4/$20은 프로모션 가격이며, 공식 요금표에는 이 가격이 적어도 2026년 11월 21일까지 제공된다고 적혀 있습니다.
표의 가격을 105만 토큰 전체 문맥에 그대로 적용하면 계산이 틀어집니다. Sol과 Luna는 모두 105만 토큰 컨텍스트를 지원하지만, 입력 27만 2천 토큰을 넘는 프롬프트에는 그 요청 전체의 입력·캐시 단가가 2배, 출력 단가가 1.5배 적용됩니다. 캐시 읽기는 기본 입력의 10% 가격이고, 캐시 쓰기에는 기본 입력보다 25% 높은 가격이 붙습니다.
API 요금과 Codex 구독 한도는 계산 방식이 다릅니다. 구독 사용량이 몇 배 늘어나는지는 토큰 가격표만으로 산출할 수 없습니다.
OpenAI 발표 수치: 업무 자동화와 코딩
공식 발표에서 비교 조건이 적힌 결과를 추렸습니다. 점수가 같아 보이더라도 추론 강도와 실행 환경이 다르면 다른 실험이에요.
| 평가 | OpenAI가 제시한 결과 | 비교 조건 |
|---|---|---|
| AutomationBench 1.0.6 | Sol xhigh 33.2%, 작업당 $0.27 | Astra low 30.3%, Claude Opus 5 max 26.9% |
| Agents’ Last Exam V1 | Sol max 56.4% | Claude Opus 5의 해당 평가 최고점보다 높고, 작업당 비용 60% 낮다는 OpenAI 설명 |
| DeepSWE v1.1 | Sol max 68.8%, Luna max 66.6% | Claude Fable 5 xhigh 최고점 69.9% |
| OSWorld 2.0 offline | Sol xhigh 60.5% | Claude Opus 5 medium 60.3% |
AutomationBench에서는 Sol xhigh가 Astra low보다 높은 점수를 냈습니다. Astra의 다른 추론 강도는 이 비교에 들어 있지 않습니다. DeepSWE의 Sol 68.8%는 비교 대상인 Fable 5의 69.9%보다 1.1%포인트 낮습니다. OSWorld는 오프라인 세트의 부분 보상 점수입니다. 비용 차이도 OpenAI가 적은 설정의 작업당 수치입니다.
OpenAI는 FrontierCode에서 Sol이 5.6 Sol보다 개선됐다고 밝혔지만, 발표 본문에는 해당 점수를 수치로 적지 않았습니다. 내부 사실성 평가의 ‘Sol 오류 약 절반’은 오류를 신고한 대화를 골라 측정한 결과입니다. 일반 대화의 오류율을 측정한 숫자는 발표문에 없습니다.
독립 코딩 평가는 Sol 상승, Luna 하락
Artificial Analysis의 9월 22일 분석은 두 모델을 Codex 하네스·max 추론 강도에서 비교했습니다. Coding Agent Index v1.5는 DeepSWE v1.1, Terminal-Bench 4.0, SWE-Atlas-QnA를 합친 지표입니다.
| AA 코딩 평가 | GPT-5.6 | GPT-6 | 차이 |
|---|---|---|---|
| Sol Coding Agent Index | 55 | 57 | +2점 |
| Sol Terminal-Bench 4.0 | 37% | 43% | +6%p |
| Sol SWE-Atlas-QnA | 54% | 58% | +4%p |
| Luna Coding Agent Index | 43 | 41 | -2점 |
| Luna SWE-Atlas-QnA | 49% | 44% | -5%p |
| Luna DeepSWE v1.1 | 66% | 64% | -2%p |
AA의 해당 코딩 과제에서 Sol max는 작업당 약 $2.99였습니다. 이전 Sol보다 약 50% 저렴했고, 지수 점수는 2점 올랐습니다. Luna는 작업당 비용이 약 60% 낮아진 대신 코딩 지수에서 2점 내려갔습니다. 공식 발표의 DeepSWE 68.8%·66.6%와 AA의 DeepSWE 하위 점수는 평가 실행 조건이 다릅니다.
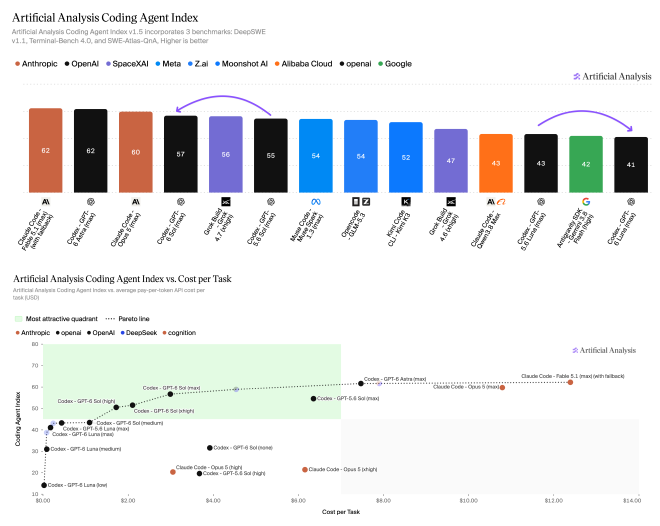
2026년 9월 22일 공개된 Coding Agent Index v1.5입니다. Sol은 55→57점, Luna는 43→41점으로 움직였습니다. 그래프의 다른 모델은 하네스와 설정이 서로 다릅니다. 출처: https://artificialanalysis.ai/articles/gpt-6-sol-and-luna-push-the-cost-efficiency-frontier
가격 인하만큼 작업당 비용도 내려갔을까?
같은 평가기관의 Intelligence Index 과제당 평균 비용은 Sol max가 $1.99에서 $1.06으로, Luna max가 $0.18에서 $0.07로 내려갔습니다. 다만 두 모델 모두 출력 토큰은 늘었습니다. Sol은 과제당 약 2만 9천→3만 1천, Luna는 약 4만 1천→5만 1천 토큰입니다. 토큰 단가와 과제 완료 비용을 별도로 볼 이유가 여기 있어요.
지식 업무의 결과도 한 방향으로 움직이지 않았습니다. AA의 AutomationBench-AA는 Sol 60→62%, Luna 50→53%로 올랐습니다. 반면 GDPval-AA v2.1에서 Sol은 약 100 Elo, Luna는 약 75 Elo 하락했고, AA-Briefcase v1.1의 Luna도 약 45 Elo 떨어졌습니다. AA는 산출물이 짧아지면서 요구 항목을 빠뜨리는 사례를 관찰했다고 설명합니다. 짧고 명료한 답변을 선호하는 작업과, 빠짐없는 보고서를 제출해야 하는 작업은 결과가 달랐습니다.
‘환각 감소’도 정확도와 함께 보면 그림이 달라집니다. AA-Omniscience에서 Sol의 환각률은 92→60%, Luna는 93→77%로 낮아졌습니다. Sol은 답변을 시도한 비율도 99→83%로 낮아졌고, 정확도는 59→54%로 떨어졌습니다. 모르는 질문에 답을 덜 한 변화가 환각률 감소에 들어 있습니다. Luna의 정확도는 43→44%로 큰 변화가 없었습니다. 이 수치는 해당 지식 평가의 정의와 문제 집합에 대한 결과입니다.
실제 사용자는 어떻게 이야기하나
Hacker News 토론, Simon Willison의 사용 기록, 개발자들의 공개 작업물을 확인했습니다. 각기 다른 작업 환경에서 올린 개인 경험입니다. GPT-5.6에 대한 회고와 GPT-6 사용 후기도 나눴습니다.
새 모델을 실제 작업에 넣은 사람들
- Simon Willison은 Datasette Agent 데모를 GPT-6 Luna로 옮긴 뒤 SQL 질의와 HTML·JavaScript 앱 생성에서 빠르고 유능했다고 적었습니다. GPT-6 Sol은 Codex의 기본 모델로 설정했어요. 펠리컨 자전거 SVG를 같은 프롬프트로 여러 추론 강도에서 생성한 비교 자료도 공개했습니다. 본인은 Astra
max결과를 가장 마음에 들어 했습니다. 이 비교는 SVG 한 종류를 한 번 생성한 결과입니다. - HN의 rbranson은 Astra를 기획·디자인, Luna를 코드 생성, Sol을 코드 검토와 통합·E2E 테스트에 배치했다고 합니다. 본인 작업에서 사용 효율과 완료 속도가 각각 약 20% 좋아졌다고 적었습니다. 작업 종류와 반복 횟수는 제시하지 않았습니다.
- HN의 jeremyjh은 OMP에서 Sol
high를 오케스트레이터, Solmax를 기획·리뷰, Lunamax를 작업·코딩 담당으로 쓴다고 밝혔습니다. 여러 세션을 동시에 돌리는 운영 방식입니다. - HN의 azuanrb은 기존 Terra 중심 작업에서 Luna
xhigh로 옮겼고, 어려운 작업에 Sol을 쓴다고 했습니다. Luna의 판단력은 자기 작업에 충분하지만 속도는 아쉽다고 적었습니다.
결과가 마음에 들지 않았다는 사례도 있습니다
- HN의 jjcm은 동일한 이미지→웹페이지 프롬프트로 Astra, Sol, Luna의 결과물을 공개했습니다. 자신의 판단으로는 Astra의 대비·전환 효과·완성도가 가장 높았고, Luna는 버튼을 잘못 구현했습니다. 작성자는 Luna가 이전에 만든 다른 사이트 파일을 참조한 점도 원인으로 들었습니다.
- HN의 dom96은 본인의 KillSwitch-Bench에서 MiMo-V2.6-Pro가 GPT-6 Sol보다 좋은 결과를 더 저렴하게 냈다고 전했습니다. 이 벤치마크는 적대적인 특수 언어 작업을 평가합니다.
- HN의 dmazin은 기존 Luna도 충분히 쌌기 때문에 코딩 지수가 내려간 새 모델보다 성능 향상에 돈을 더 쓸 의향이 있다고 적었습니다. 가격 인하보다 특정 작업의 성능을 중시하는 반응입니다.
5.6 Sol을 오랫동안 써온 m_fayer의 글도 눈에 남았습니다. 이 이용자는 기존 모델의 소통 방식과 작업 감각을 좋아해서 후속 모델이 달라질까 걱정한다고 했습니다. 기존 모델 사용자의 기대와 우려를 보여주는 글입니다.
작은 작업에 Luna를 쓰고 Sol로 검토하는 구성이 통했다는 경험이 있습니다. 코딩 지수와 UI 구현에서는 Luna가 뒤처진 사례도 나왔습니다. rbranson이 말한 20% 효율 개선은 그 이용자의 작업 결과입니다.
캐시와 제공 위치는 사용 경로마다 다릅니다
공통 접두 문맥을 30분 안에 다시 쓰면 캐시 할인 대상이 됩니다. GPT-6 캐싱 발표에는 캐시 적중률 대시보드와 진단 도구, 명시적 캐시 구간도 나왔습니다. GitHub는 OpenAI 모델에 보낸 수십억 건의 요청에서 새로 처리할 프롬프트 토큰 비율이 지난 몇 달간 50% 넘게 줄었다고 밝혔습니다. GitHub의 전체 요청을 집계한 운영 수치입니다.
API 식별자는 gpt-6-sol, gpt-6-luna입니다. OpenAI 안내 기준으로 Plus·Pro·Business·Enterprise·Edu 이용자는 ChatGPT Work와 Codex에서 둘 다 사용 가능하고, Free·Go는 데스크톱 앱에서 Luna를 사용할 수 있습니다. 일반 Chat에는 발표 당시 아직 제공되지 않았고 순차 배포 예정입니다. GitHub Copilot 발표에는 Sol은 Pro+·Max·Business·Enterprise, Luna는 Pro부터 제공하며 두 모델 모두 순차 배포라고 적혀 있습니다. Copilot 요금은 OpenAI API 가격표 대신 Copilot의 사용량 기반 과금 안내를 따릅니다.
정리하면
Sol은 독립 코딩 지수에서 55→57점으로 소폭 올랐고 작업당 비용은 내려갔습니다. Luna는 코딩 지수가 43→41점으로 내려갔지만 훨씬 저렴해졌습니다. 지식 업무 평가에서는 두 모델 모두 빠진 항목이 늘었다는 결과가 있었고, Sol의 환각률 감소에는 답변을 보류한 비율 증가가 섞여 있습니다.
출시 초기 후기에서 가장 구체적인 이야기는 모델을 역할별로 나눠 쓴 사례였습니다. 반복 작업에는 Luna, 검토에는 Sol을 쓰는 방식이 눈에 띕니다. AA는 지식 업무 산출물에서 필수 항목을 빠뜨리는 사례도 관찰했습니다.
참고 자료
- OpenAI, Introducing GPT-6 Sol and Luna
- OpenAI API 요금표 · Sol 모델 문서 · Luna 모델 문서
- Artificial Analysis, GPT-6 Sol and Luna push the cost efficiency frontier
- Simon Willison, Claude Opus 5.5, GPT-6 Sol, GPT-6 Luna, and a new price war
- Hacker News, GPT-6 Sol and Luna 토론
- OpenAI, Better prompt caching for GPT-6
- GitHub Copilot 출시 안내
댓글