트롤링의 Claude Opus 5.5 출시 소식을 보고 가장 궁금했던 건 점수보다 작업 중의 감각이었습니다. 바로 전 GPT-6 Sol·Luna 글을 쓰면서도 벤치마크와 실제 사용 후기가 꽤 다른 이야기를 한다고 느꼈거든요.
Opus 5.5는 공식 코딩 평가 점수가 높고 가격도 내려갔습니다. 그런데 Artificial Analysis의 독립 측정에서는 같은 이름의 코딩 평가가 공식 발표보다 낮게 나왔고, 높은 추론 강도에서는 작업당 출력량이 늘었습니다. 출시 직후 개발자들의 글쓰기 체감도 엇갈립니다. 발표 수치와 직접 써본 사람들의 사례를 따로 놓고 봤습니다.
2026년 9월 22일 공개된 Opus 5.5의 공식 출시 이미지입니다. 출처: https://www.anthropic.com/claude-opus-5-5
가격은 얼마나 내려갔나요?
Anthropic 발표에서 가장 먼저 확인할 숫자는 토큰 100만 개당 API 요금입니다. Opus 5보다 입력·출력은 각각 20%, 캐시 읽기는 60% 저렴해졌어요. 5분 캐시 쓰기도 내려갔습니다.
| API 요금 / 100만 토큰 | Opus 5 | Opus 5.5 |
|---|---|---|
| 입력 | $5 | $4 |
| 출력 | $25 | $20 |
| 캐시 읽기 | $0.50 | $0.20 |
| 5분 캐시 쓰기 | $6.25 | $5 |
가격은 Anthropic API 요금표 기준입니다.
회사가 말한 일반 작업 비용 40% 절감은 기본 설정에서 사용 토큰 수도 줄었다는 자체 테스트 결과입니다. 실제 청구액은 작업별 토큰 사용량과 캐시 적중량에 따라 달라집니다. Fast mode는 Claude Code와 Claude Platform에서 최대 2.5배 빠르게 제공되지만 입력 $8·출력 $40/100만 토큰으로 표준 요금의 두 배입니다.
Simon Willison의 가격 비교를 보면 GPT-6 Sol의 표준 입력·출력은 $2/$10으로 Opus 5.5의 절반이고, 캐시 읽기는 둘 다 $0.20입니다. 두 모델의 실제 작업비용은 완료까지 쓴 토큰과 성공률에 따라 달라집니다. 구독의 5시간 사용 한도는 Anthropic이 Pro·Max·Team·seat 기반 Enterprise에서 늘렸다고 발표했지만, API 가격표만으로는 구독에서 요청을 몇 번 더 보낼 수 있는지 계산할 수 없습니다.
Anthropic 발표: 코딩 평가는 세 항목 모두 상승
Anthropic이 공개한 코딩 평가에서 Opus 5.5는 Opus 5보다 Terminal-Bench 4.0 52.3→66.4%, FrontierCode v1.1 48.0→54.4%, CursorBench 4.0 46.6→57.8%로 앞섰습니다. 각 점수는 해당 평가 과제의 결과예요.
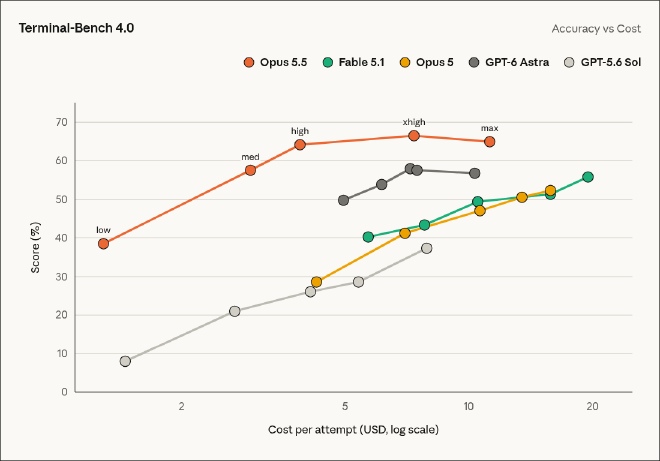
가로축은 시도당 비용의 로그 눈금, 세로축은 점수입니다. 위 본문의 66.4%는 Opus 5.5 xhigh 결과입니다. Anthropic 사이트의 인터랙티브 차트를 캡처했습니다. 출처: https://www.anthropic.com/claude-opus-5-5
Anthropic의 Terminal-Bench 4.0 표에는 GPT-6 Astra 57.9%도 함께 있습니다. 이 값은 OpenAI가 보고한 high 설정이고, Opus 5.5의 66.4%는 Anthropic의 xhigh 결과입니다. 서로 다른 회사의 실행 결과와 추론 강도를 한 표에서 비교한 셈이에요. Opus 5.5 점수의 표준오차도 ±2.6%포인트로 적혀 있습니다. 공식 발표는 대부분의 Opus 5.5 점수를 adaptive thinking max로 측정했다고 밝혔습니다.
코딩 사례에서는 숫자보다 작업 규모가 먼저 보입니다. Anthropic에 따르면 한 초기 테스터는 68만 줄 규모의 코드 마이그레이션을 하루 안에 끝냈고, 자사 HAProxy C→Rust 변환 시험에서는 Opus 5.5가 9.5시간, Fable 5.1이 12시간 걸렸습니다. 둘 다 HAProxy 회귀 테스트 대부분을 통과했다고 합니다. 각각 사전 공개 테스터의 작업과 회사 내부 시험입니다.
독립 평가에서는 같은 Terminal-Bench가 59.6%
Artificial Analysis의 9월 22일 분석은 Opus 5.5의 Terminal-Bench 4.0 결과를 59.6%로 기록했습니다. AA 측정에서는 GPT-6 Astra xhigh와 동률이고, Opus 5보다 약 11%포인트 높습니다. 공식 발표의 66.4%와는 6.8%포인트 차이가 납니다. 두 수치는 실행 조건이 다른 별개의 결과입니다.
AA의 Intelligence Index에서는 Opus 5.5 max가 58점으로 당시 측정 모델 중 가장 높았습니다. 이 지수는 코딩만 집계한 점수가 아니라 지식 업무·과학 추론 등을 포함한 10개 평가의 종합 점수입니다. 지식 업무의 AA-Briefcase v1.1에서는 1822 Elo로 Fable 5.1보다 143점 높았습니다. 반면 AA는 CritPt, AA-LCR, GDP.pdf에서는 선두에 미치지 못했다고 적었습니다.
작업당 비용은 추론 강도에 따라 달라집니다
AA가 측정한 Intelligence Index의 작업당 평균 비용은 Opus 5.5 low $0.55, 기본값인 medium $1.34, high $1.82, xhigh $3.46, max $5.98입니다. 점수는 각각 42·51·54·56·58점이었어요. 이 비용은 AA의 해당 평가 과제에서 입력·캐시·추론·답변 토큰을 합산한 값입니다. 일반적인 코드 수정 작업에는 다른 비용이 나옵니다.
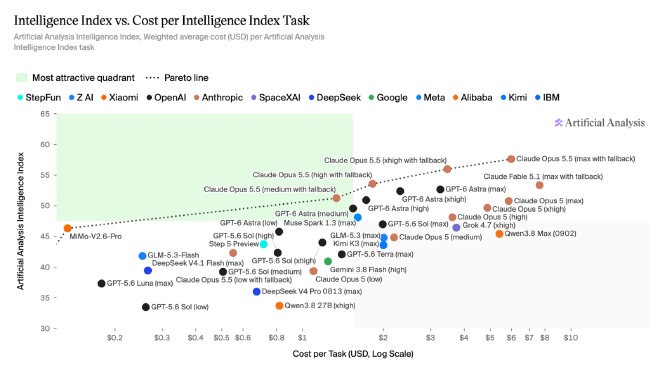
Opus 5.5의 medium·high·xhigh·max가 성능 대비 비용의 Pareto 경계에 있습니다. AA 평가 과제의 가중 평균 비용이며 일반 코딩 작업의 요금과는 다릅니다. 출처: https://artificialanalysis.ai/articles/claude-opus-5-5
이 결과에는 가격 인하와 별개의 변화도 있습니다. AA의 max 설정에서 Intelligence Index 작업당 출력 토큰은 Opus 5.5 약 11만 9천 개, Opus 5 약 7만 3천 개였습니다. 해당 지수의 과제별 출력량 평균입니다. AA는 출력이 약 1.6배 늘었는데도 해당 평가의 작업당 비용은 Opus 5와 비슷하다고 정리했습니다. 단가와 총비용을 따로 보고 싶은 이유죠.
사용자 후기는 어디서 갈렸나요?
Hacker News 출시 토론에는 이전 Opus 5에 대한 불만과 새 모델의 첫 사용기가 섞여 있습니다. 여기서는 Opus 5.5를 실제로 돌렸다고 밝힌 사례만 골랐습니다. 작업 환경이 다른 개인 기록입니다.
코드 리뷰: 더 많이 잡았지만 비용은 거의 같았다는 사례
HN의 gwd는 문제 14개가 포함된 메일링 리스트 패치 12개를 검토하는 자신의 하네스 결과를 공개했습니다. Opus 5.5는 14개 중 8개를 찾았고, Fable 5.1은 7개, Opus 5는 6개, Sonnet 5는 2개였습니다. 표시된 비용은 각각 $15.40, $66.34, $15.19, $19.15입니다. Opus 5.5가 이 작은 표본에서 가장 많이 찾았지만 Opus 5보다 비용은 $0.21 높았습니다. 작성자는 Claude CLI가 보고한 API 환산 비용이며 실제 결제는 구독으로 했다고 덧붙였습니다.
HN의 epicepicurean은 자기 저장소의 스케줄러 동작을 짧게 설명하되 정확성에 필요한 내용을 빠뜨리지 말라는 프롬프트와 Opus 5.5의 실제 답변 일부를 올렸습니다. lease·watermark·재시도 시의 불변조건을 따라갈 수 있는 설명이었다며 Opus 5보다 낫다고 평가했습니다. 특정 저장소에서 나온 설명 한 건이지만 실제 답변 예시를 함께 볼 수 있습니다.
글쓰기: 개선됐다는 사람과 그대로라는 사람
Anthropic은 Opus 5.5가 핵심을 먼저 말하고 덜 장황하게 쓴다고 소개했습니다. 실제 반응은 한 방향이 아니었어요. HN의 sdthjbvuiiijbb는 당일 사용에서 문장이 눈에 띄게 읽기 좋아졌다고 적었습니다. 반대로 ascendantlogic은 한 시간 써보니 Opus 5처럼 장황했고 특정 표현을 네 번 반복했다고 했습니다. cruffle_duffle도 첫 세션에서 중요한 내용을 긴 문장 뒤에 묻는 버릇이 남았다고 느꼈습니다. 이 후기들은 모두 출시 첫날의 짧은 사용 기록입니다.
HN의 consumer451은 같은 애니메이션 입력을 claude.ai의 Opus 5와 5.5 high에 넣어 두 결과물을 비교했고, 5.5의 3D 애니메이션이 크게 나아졌다고 적었습니다. 다만 claude.ai의 시스템 프롬프트나 스킬도 달라졌을 수 있어 모델만의 개선으로 돌릴 수 없다고 작성자가 직접 밝혔습니다.
추론을 최대로 올리면 작업이 끝나지 않을 수도 있습니다
Simon Willison은 같은 SVG 프롬프트로 Opus 5.5의 low부터 max까지 시험했습니다. low·medium·high·xhigh에서는 자전거를 탄 펠리컨 그림이 나왔고, max에서는 두 번 모두 128,000 출력 토큰 한도를 그림을 내놓기 전 추론에 써버렸습니다. 각 실패에는 $2.56, 약 20분이 들었다고 기록했습니다.
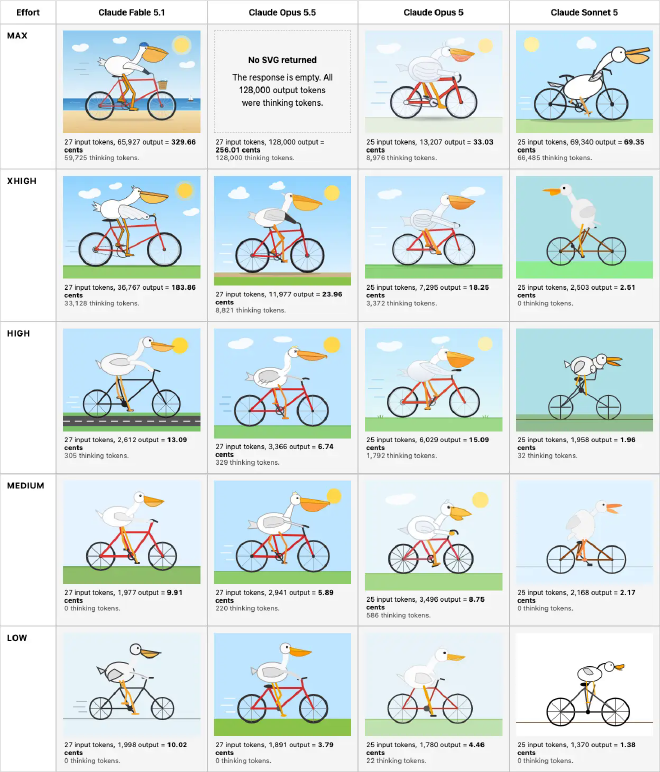
Opus 5.5의 max 칸에는 결과 이미지가 없습니다. Simon Willison이 SVG 생성 프롬프트에서 두 번 겪은 실패입니다. 일반 코딩 작업의 실패율과는 별개입니다. Simon Willison의 원본 비교 이미지. 출처: https://simonwillison.net/2026/Sep/22/opus-and-sol-and-luna/
이 사례를 보고 저는 단순 작업부터 무조건 max로 올릴 이유가 줄었습니다. 같은 글에서 Simon은 Opus 5.5를 Claude Code의 기본 모델로 설정했다고 썼지만, 직접 결과와 비용을 자세히 보여준 시험은 펠리컨 SVG입니다.
제공 범위와 안전장치는 실제 작업에 어떻게 적용되나요?
Anthropic 모델 문서의 API 식별자는 claude-opus-5-5이고, 컨텍스트 창은 100만 토큰, 동기식 Messages API의 최대 출력은 12만 8천 토큰입니다. 기본 추론 강도는 medium입니다. Anthropic은 Claude Platform과 주요 클라우드 제공사에서도 모델을 제공한다고 밝혔습니다.
공식 벤치마크에는 production 안전장치가 켜져 있었습니다. Anthropic 설명에 따르면 일부 사이버보안 작업은 Opus 4.8, 생물학 및 프런티어 LLM 개발 작업은 Opus 5로 전환돼 처리됐습니다. 보안 민감 작업에서는 이 전환이 평가 점수와 실제 작업 경로에 영향을 줄 수 있습니다. 출시 첫날의 HN 토론에는 이전 모델의 안전필터 때문에 작업이 중단됐다는 경험도 보이지만, 그것을 Opus 5.5의 직접 실패 사례로 세지는 않았습니다.
정리하면
공식 코딩 평가에서는 Opus 5.5의 개선 폭이 큽니다. 독립 평가에서도 Terminal-Bench 4.0이 Opus 5보다 올랐지만, 공식 발표의 66.4% 대신 AA에서는 59.6%였습니다. AA의 종합 지수는 58점으로 높고, max 작업당 출력 토큰도 크게 늘었습니다.
실사용에서는 작은 패치 리뷰에서 더 많은 문제를 찾았다는 기록과, 문장 전달 방식이 여전히 거슬린다는 후기가 함께 나왔습니다. 특히 Simon의 max 실패는 높은 추론 강도가 모든 프롬프트에 유리하지 않다는 생생한 사례입니다. 제 기준에서는 코딩 평가의 상승보다 medium에서 작업을 제대로 마치는지가 다음 비교에서 더 궁금합니다.
댓글